Bài 8 — Tại sao ChatGPT chọn từ tiếp theo với xác suất 92% thay vì 100%?
Bạn gõ "Hôm nay trời rất..." và ChatGPT viết tiếp "nắng".
Quản trị viên
20 tháng 9, 2026· 7 phút đọc
Bạn gõ "Hôm nay trời rất..." và ChatGPT viết tiếp "nắng".
Nó không tra từ điển. Bên trong, nó vừa chấm điểm cho khoảng năm mươi nghìn từ trong vốn từ vựng, rồi chọn từ có điểm cao nhất. Nhưng câu hỏi thú vị hơn là: nếu nó đã chọn "nắng", tại sao mọi người luôn nói nó chọn với xác suất chứ không phải ?
Câu trả lời nằm ở hai hàm số mà bạn học ở Toán 11: hàm mũ và hàm logarit.
Vấn đề: điểm số không phải xác suất
Sau khi chạy hết các lớp mạng nơ-ron (Bài 7), máy có một danh sách điểm số thô. Ví dụ với ba từ ứng viên:
| Từ ứng viên | Điểm thô |
|---|---|
| "nắng" | |
| "mưa" | |
| "bão" |
Những con số này gọi là logits. Chúng có hai vấn đề khiến không dùng thẳng được:
- Có thể âm. Một từ rất khó xảy ra có thể được chấm . Mà xác suất thì không âm bao giờ.
- Không cộng lại thành 1. Ở đây , không phải .
Vậy cần một phép biến đổi làm hai việc cùng lúc: đưa mọi số về dương, và ép tổng bằng .
Ý tưởng: dùng hàm mũ
Hàm có đúng tính chất cần: nó luôn dương, với mọi kể cả âm.
Vậy bước 1: mũ hoá mọi điểm số. Bước 2: chia mỗi cái cho tổng, để tổng bằng .
Hai bước ấy gộp lại gọi là hàm Softmax:
Cái tên cũng có lý do: nó là bản "mềm" (soft) của phép lấy lớn nhất (max). Phép max cứng sẽ cho từ điểm cao nhất xác suất và các từ khác . Softmax vẫn ưu ái từ điểm cao nhưng chừa lại một phần cho các từ khác.
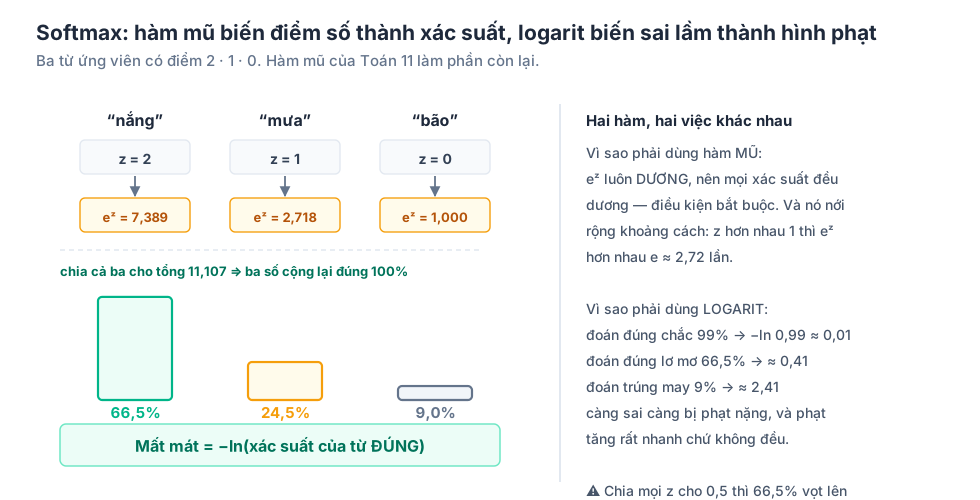
Trực quan hoá
Giải bài toán mẫu
Bước 1 — Mũ hoá từng điểm. Bấm máy:
Bước 2 — Cộng lại:
Bước 3 — Chia từng cái cho tổng:
Kiểm: ✓
Chú ý một điều đáng ngạc nhiên: điểm thô của "nắng" chỉ gấp đôi điểm của "mưa" ( so với ), nhưng xác suất thì gấp gần ba lần ( so với ). Hàm mũ nới rộng khoảng cách: chênh nhau điểm thì chênh nhau lần về xác suất.
"Nhiệt độ": vì sao ChatGPT có lúc sáng tạo, có lúc khô khan
Trước khi mũ hoá, mô hình chia mọi điểm cho một số gọi là nhiệt độ:
Thử với cùng bộ điểm. Lúc này thành , , :
Từ vọt lên . Nhiệt độ thấp ⇒ phân bố nhọn ⇒ mô hình gần như luôn chọn từ điểm cao nhất ⇒ trả lời nhất quán nhưng nhàm.
Nhiệt độ cao thì ngược lại: phân bố dẹt, các từ ít khả năng cũng có cơ hội ⇒ văn phong đa dạng hơn nhưng dễ lạc đề.
Đó chính là nút "creativity" trong các ứng dụng AI — và nó là một phép chia trước khi mũ hoá.
Nửa còn lại: logarit dùng để phạt
Softmax cho ra dự đoán. Nhưng lúc huấn luyện, máy cần một con số đo mức sai để đưa vào Gradient Descent (Bài 5).
Giả sử câu đúng thật sự là "nắng". Mô hình gán cho "nắng" xác suất . Mức phạt được định nghĩa:
Vì sao lại là logarit? Hãy xem bảng:
| Mô hình gán cho từ đúng | Mất mát |
|---|---|
| (rất chắc, và đúng) | |
| (đúng nhưng lơ mơ) | |
| (trúng do may) | |
| (sai hẳn) | |
| (sai chắc chắn) |
Ba tính chất làm logarit đúng là hàm cần tìm:
- Luôn không âm. Vì nên , đổi dấu thành .
- Phạt tăng rất nhanh khi sai. Từ xuống — xác suất giảm 7 lần nhưng mức phạt tăng gần 6 lần. Từ xuống thì phạt lại gần gấp đôi. Mô hình bị ép tránh những lần sai nặng trước khi lo tối ưu các lần đã gần đúng.
- Sai chắc chắn thì phạt vô hạn. Gán cho điều thật sự xảy ra là sai lầm không thể tha thứ — và hàm nói đúng điều đó.
Đại lượng này tên là Cross-Entropy Loss, hàm mất mát được dùng nhiều nhất trong toàn bộ ngành học máy.
Trở lại câu hỏi ở tiêu đề
Vì sao không bao giờ là ?
Nhìn lại công thức: . Muốn thì mẫu số phải bằng đúng tử số, tức mọi khác phải bằng . Nhưng với mọi — hàm mũ không bao giờ nhận giá trị .
Vậy là điều toán học không cho phép, chứ không phải mô hình còn lưỡng lự.
Và điều đó lại rất đáng mừng. Một hệ thống luôn tuyệt đối chắc chắn là một hệ thống không biết mình có thể sai. Chính cái còn lại ấy là chỗ mô hình thừa nhận: "có thể là từ khác".
Thử thách tự tính
Một mô hình phân loại ảnh cho ba lớp với điểm thô: mèo , chó , chim .
Câu hỏi 1. Tính , , và tổng của chúng (lấy ba chữ số thập phân).
Câu hỏi 2. Tính xác suất softmax cho cả ba lớp, làm tròn tới . Kiểm tổng bằng .
Câu hỏi 3. Ảnh thật là mèo. Tính mất mát .
Câu hỏi 4. Nếu cả ba điểm thô đều bằng nhau (ví dụ cùng bằng ), xác suất mỗi lớp là bao nhiêu? Mất mát khi ấy bằng bao nhiêu?
Đáp án
Câu 1. ; ; . Tổng .
Câu 2.
Câu 3. . Mức phạt nhỏ — mô hình vừa đúng vừa khá chắc.
Câu 4. Điểm bằng nhau ⇒ mũ bằng nhau ⇒ mỗi lớp . Mất mát .
Đây là mức phạt của một mô hình chưa học gì cả, chỉ đoán đều. Khi huấn luyện, con số cần theo dõi là mất mát có tụt xuống dưới hay không — nếu không, mô hình chưa học được gì.
Lời kết cho cả series
Tám bài, tám mảng kiến thức, và không bài nào phải đi quá chương trình phổ thông:
| Bài | Toán THPT | Khái niệm AI |
|---|---|---|
| 1 | Vectơ, toạ độ | Vector Embedding |
| 2 | Tích vô hướng | Cosine Similarity |
| 3 | Đường thẳng, bất phương trình | Perceptron |
| 4 | Cực trị parabol | Hồi quy & hàm mất mát |
| 5 | Đạo hàm, tiếp tuyến | Gradient Descent |
| 6 | Xác suất có điều kiện, Bayes | Naive Bayes |
| 7 | Nhân ma trận | Forward Propagation |
| 8 | Hàm mũ, logarit | Softmax & Cross-Entropy |
Điều đáng rút ra không phải là "AI dễ". Xây một mô hình thật đòi kỹ thuật, dữ liệu và sức tính toán khổng lồ. Điều đáng rút ra là nền móng của nó không xa lạ. Những công cụ ấy nằm trong sách giáo khoa của bạn, và chúng được chọn không phải vì đẹp mà vì chúng làm được việc: đo độ giống, chia hai nhóm, tìm điểm thấp nhất, cập nhật niềm tin khi có bằng chứng mới.
Lần tới khi ai đó hỏi "học Toán để làm gì", bạn có tám câu trả lời cụ thể — và mỗi câu đều kiểm chứng được bằng một chiếc máy tính cầm tay.
Muốn luyện chắc phần hàm mũ và logarit, thầy cô và các bạn có thể dựng bộ đề riêng trên Grade: chấm tự động ngay khi nộp kèm lời giải chi tiết từng câu. Dùng thử miễn phí tại đây.
Bắt đầu học cùng Grade
Luyện tập, kiểm tra trình độ và theo dõi tiến độ học tập đa môn — trên web và điện thoại.