Bài 3 — Làm thế nào để kẻ một đường thẳng chia email thành "Spam" và "Không Spam"?
Mỗi ngày Gmail chặn hàng tỉ thư rác. Bạn gần như không bao giờ thấy chúng — chúng bị đẩy vào thư mục Spam trước khi bạn kịp mở hộp thư.
Quản trị viên
15 tháng 9, 2026· 6 phút đọc
Mỗi ngày Gmail chặn hàng tỉ thư rác. Bạn gần như không bao giờ thấy chúng — chúng bị đẩy vào thư mục Spam trước khi bạn kịp mở hộp thư.
Không có người nào ngồi đọc từng thư. Cũng không có danh sách "các từ cấm" nào đủ dài. Thứ làm việc đó là một mô hình toán học ra đời năm 1958, tên là Perceptron — và nó đơn giản tới mức bạn học đủ công cụ để hiểu nó ngay từ học kỳ I lớp 10.
Ý tưởng: đo hai dấu hiệu, rồi kẻ một đường
Giả sử ta mô tả mỗi email bằng hai con số đếm được:
- = số lần xuất hiện chữ "khuyến mãi"
- = số liên kết (link) trong thư
Bốn email thật trong hộp thư:
| Thực tế | |||
|---|---|---|---|
| A — thư của cô giáo | không spam | ||
| B — quảng cáo sàn thương mại | spam | ||
| C — bản tin trường | ranh giới | ||
| D — thư ngân hàng | không spam |
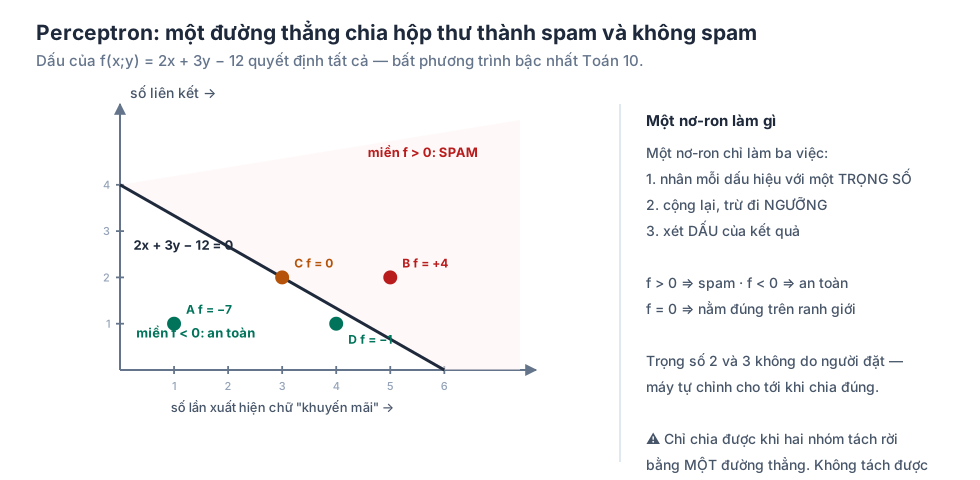
Chấm bốn điểm ấy lên mặt phẳng , ta thấy spam nằm về phía trên bên phải, thư thật nằm về phía dưới bên trái. Vậy chỉ cần kẻ một đường thẳng tách hai nhóm.
Trực quan hoá
Đường thẳng trong hình là
Nó cắt trục hoành tại và trục tung tại — bạn kiểm được bằng cách cho lần lượt rồi .
Máy quyết định thế nào: xét dấu
Đặt
Toán 10 đã dạy: đường thẳng chia mặt phẳng thành hai nửa mặt phẳng, và giữ nguyên một dấu trên mỗi nửa. Đó là toàn bộ cơ chế quyết định:
| Dấu của | Kết luận |
|---|---|
| SPAM | |
| thư thật | |
| nằm đúng trên ranh giới |
Giải bài toán mẫu
Thay toạ độ bốn email vào :
Email A:
Email B:
Email C:
Đúng — email này nằm chính xác trên đường thẳng. Máy không quyết được, và đây là một tình huống có thật: bản tin trường có cả link lẫn chữ "khuyến mãi" nhưng hoàn toàn hợp lệ. Trong thực tế, những email như vậy bị đẩy vào mục "Quảng cáo" thay vì "Spam".
Email D:
Chú ý D: giá trị rất sát . Thư ngân hàng nhiều link và có thể có chữ "khuyến mãi" — nó suýt bị xếp nhầm. Đây chính là loại thư hay bị lọc oan trong đời thực.
Bốn email, bốn lần thay số, bốn lần xét dấu. Không có gì hơn thế.
Ba con số ấy từ đâu ra?
Câu hỏi đúng nhất mà một học sinh nên hỏi: tại sao lại là , và ?
Ba con số đó có tên riêng trong AI:
| Trong Toán | Trong AI | Ý nghĩa |
|---|---|---|
| hệ số của () | trọng số | chữ "khuyến mãi" quan trọng cỡ nào |
| hệ số của () | trọng số | số link quan trọng cỡ nào |
| hằng số () | ngưỡng (bias) | phải "đáng ngờ" tới mức nào mới bị chặn |
Và không ai đặt chúng bằng tay. Máy bắt đầu bằng ba số ngẫu nhiên, rồi lặp:
- Lấy một email đã biết nhãn, tính .
- Nếu phân loại đúng — không làm gì.
- Nếu phân loại sai — dịch ba con số một chút theo hướng làm lần sau đỡ sai hơn.
Lặp vài nghìn lần trên vài nghìn email, đường thẳng tự trượt về đúng chỗ. Cách "dịch một chút" ấy chính là nội dung của Bài 5.
So sánh với trọng số lớn hơn : máy đã tự học ra rằng số link là dấu hiệu mạnh hơn số lần xuất hiện một từ. Không ai dạy nó điều đó.
Giới hạn: khi một đường thẳng là không đủ
Perceptron chỉ chia được khi hai nhóm tách rời được bằng một đường thẳng. Đây không phải chi tiết nhỏ — nó suýt giết chết cả ngành AI.
Năm 1969, hai nhà nghiên cứu chỉ ra rằng perceptron không giải nổi một bài toán cực kỳ đơn giản: hàm XOR, tức bài "đúng khi một và chỉ một trong hai điều kiện xảy ra". Bốn điểm , , , với nhãn xen kẽ nhau — bạn thử kẻ một đường thẳng tách chúng mà xem, không có đường nào cả.
Kết luận ấy làm nguồn tài trợ cho AI cạn kiệt gần hai chục năm, giai đoạn nay gọi là "mùa đông AI".
Lối thoát hoá ra rất tự nhiên: chồng nhiều đường thẳng lên nhau thành nhiều lớp. Lớp thứ nhất kẻ vài đường, lớp thứ hai kết hợp kết quả của chúng, và ranh giới tổng hợp không còn thẳng nữa. Đó chính là mạng nơ-ron nhiều lớp — thứ ta sẽ gặp lại ở Bài 7.
Thử thách tự tính
Một bộ lọc dùng hai dấu hiệu: = số dấu chấm than trong tiêu đề, = số chữ viết HOA toàn bộ. Hàm quyết định:
Bốn email đến:
| E | ||
| F | ||
| G | ||
| H |
Câu hỏi 1. Tính cho cả bốn email và cho biết email nào bị xếp là spam.
Câu hỏi 2. Email G cho kết quả gì đặc biệt? Nó nói lên điều gì?
Câu hỏi 3. Tìm toạ độ giao điểm của đường với hai trục toạ độ.
Câu hỏi 4. Nếu người quản trị muốn bộ lọc khắt khe hơn (bắt được nhiều spam hơn), nên tăng hay giảm con số ?
Đáp án
Câu 1.
- E: → thư thật
- F: → spam
- G: → trên ranh giới
- H: → trên ranh giới
Chỉ F bị xếp là spam.
Câu 2. G cho , tức nằm đúng trên đường phân chia. Máy hoàn toàn không có căn cứ để nghiêng về bên nào — với những ca này, hệ thống thật thường chuyển sang xét thêm dấu hiệu khác thay vì đoán bừa.
Câu 3. Cho : , được điểm . Cho : , được điểm . (Chú ý H nằm đúng tại giao điểm này.)
Câu 4. Giảm con số . Ngưỡng thấp hơn ⇒ dễ dương hơn ⇒ nhiều email bị coi là spam hơn. Nhưng đổi lại sẽ có nhiều thư thật bị chặn oan — đây đúng là sự đánh đổi mà mọi bộ lọc thư rác phải cân.
Lời kết
Viên gạch nhỏ nhất của trí tuệ nhân tạo hiện đại — cái gọi là "nơ-ron" — không phải thứ gì bí ẩn. Nó là một phương trình đường thẳng cộng với một phép xét dấu, đúng hai nội dung nằm cạnh nhau trong sách Toán 10.
Thứ làm nên sức mạnh không nằm ở một nơ-ron. Nó nằm ở việc xếp hàng triệu nơ-ron như vậy thành nhiều lớp, và ở việc máy tự tìm ra các trọng số thay vì chờ người đặt.
Bài 4 sẽ hỏi một câu hỏi khác: nếu không phải phân loại mà là dự đoán một con số — ví dụ giá nhà — thì đường thẳng nào là đường "vừa nhất"? Câu trả lời nằm ở đỉnh của một parabol.
Muốn luyện chắc phần đường thẳng và bất phương trình bậc nhất hai ẩn, thầy cô và các bạn có thể dựng bộ đề riêng trên Grade: chấm tự động ngay khi nộp kèm lời giải chi tiết từng câu. Dùng thử miễn phí tại đây.
Bắt đầu học cùng Grade
Luyện tập, kiểm tra trình độ và theo dõi tiến độ học tập đa môn — trên web và điện thoại.